A legutóbbi blogbejegyzést ott hagytam abba, hogy elkezdtem letölteni sok-sok magyar döntést, ami a gyakorló ügyvédek számára érdekes lehet. Azóta a birtokomba került 13.000 alkotmánybírósági döntés, 7.890 versenyhatósági döntés és kapcsolódó bírósági döntések, 1.918 MNB állásfoglalás, 519 NAIH-féle irat, 4.654 döntés a Nemzeti Kereskedelmi és Fogyasztóvédelmi Hatóságtól, az NMHH döntései közül 24.600 médiatanácsi döntés, 885 db. szerzői és iparjogvédelmi szakértői testületi döntés, 1.540 ügyvédi kamarai fegyelmi határozat, több ezer közzétett földforgalmi hirdetmény (földhasználati és adásvételi szerződések), és több mint 225.000 döntés a Bírósági Határozatok Gyűjteményéből.
Az első lépés, hogy a számomra fontos döntéseket egységes, gép által olvasható formátumra hozzam. A kamarai fegyelmi határozatok egyszerű szövegként lettek letöltve, de például a BHGY esetén 2022-ig minden döntés ún. Rich Text Format (.rtf)1 és “.docx”, azaz OOXML formátumban2 készült. Az AB és a Médiatanács döntései a weboldalakról jól ismert HTML-ben vannak, a domaines döntések hol PDF3-ben, hol HTML-ben. Nagyon népszerű máshol is a PDF: a földforgalmi hirdetménnyel érintett szerződések, az MNB, a GVH, az NKFH és az SZTNH-s szakértői testületek is csak ilyen formátumokat használnak.
Ha egy kicsit közelebbről megvizsgáljuk a letöltött állományokat, egy adott formátumon belül is találhatunk olyan további eltéréseket, amely miatt tovább kell velük dolgozni, hogy együtt lehessen őket olvasni. Az is igaz, hogy egészen más az egyes közzétett döntések “tisztasága”, informatikai megbízhasága. Így pl. a BHGY-k esetén is 2022-ig a döntések kb. 1%-ában olyan nyilvánvaló felismerési hibák vannak, amelyek abból erednek, hogy a forrásdöntés nem elektronikusan készült, hanem azt karakterfelismeréssel (Optical Character Recognition, OCR) alakították át egy papír eredetiről. Ilyen hiba például az, ha a döntés szövegébe bekerült az egyébként fej- vagy láblécben szereplő ügyszám vagy oldalszám: 2003 és 2014 között a döntések 2-4%-ában találhatunk ilyen hibát, 2015-től már ez 0,5% alatti. Vagy a GVH döntések közül 1.876 döntés esetén látható volt, hogy az ő és ű betűket hibásan, pont nélkül i-ként jelölték a PDF szövegrétegében: tehát a látható részt olvasó embernek ez nem tűnik fel, de a gép számára az “előfizető” “elıfizetı” lett. Ennek az oka egy-két, a PDF létrehozására használt eszköz hibás konfigurációja volt stb., ami a 2007-2010 közöttieket érintette. Nagyjából 46 döntés esetén a GVH megakadályozta, hogy azokon OCR-t lehessen futtatni. A legkeményebb dió persze a földhivatali hirdetmények sora, ahol nagyon eltérő szkennelési minőséget tapasztalhatunk. Van, amit digitális aláírással láttak el, de találkozhatunk a “rossz szkennelések” adminisztratív iskolapéldájáig mindennel, a ferde oldalaktól a halvány és elmosódott betűkig, kisfelbontású fénymásolatokkal stb.
A PDF egy sokoldalú formátum, ezért előfordulhat, hogy néhány PDF csak képeket tartalmaz (lásd pl. a földforgalmi hirdetményes szerződéseket), kijelölhető-másolható szöveget nem. Ezek esetében a képeken nekem kell OCR-t lefuttatni, és vagy a PDF-et kibővíteni a felismert szöveges elemekkel vagy a felismert szöveget külön szövegfájlba lementeni. A többség valamilyen szinten géppel olvasható szöveget is tartalmaz már: ilyenkor az oldal tartalomleírási részében (page content stream) szöveges elemek vannak, és ezeket karakterfelismerés nélkül el lehet olvasni, ki lehet exportálni.
A mai bejegyzésem erről az összefüggő problémakörről szól: az OCR nehézségeiről (beleértve az ügyvédek rendelkezésére álló opciókról). A következő rész szól majd az adattisztítás rejtelmeiről.
Az optikai karakterfelismerés, az OCR
Az OCR célja, hogy bármilyen képből gép által közvetlenül olvasható szöveget állítson elő. A forrás lehet egy szkennelt dokumentum, fotó vagy akár PDF fájl is.
A hetvenes évekig az OCR leginkább akkor működött, ha kifejezetten erre a célra szánt írást (mágneses tintát, vagy dedikált betűtípust) kellett valami nagyszámítógépnek beolvasnia. Ekkor a számítógépek már elég erősek voltak ahhoz, hogy egy-egy konkrét betűforma beazonosítása helyett az egyes betűk formálását, alaki jellemzőit is fel tudták már ismerni, és a fix szélességű (pl. írógépes) betűtípusok mellett már a nyomdai életben használt ún. arányos betűket is képesek voltak felismerni. Ezért hívták ezt az “omnifont”, bármely betűtípus felismerésének, ami persze az utóbbi évtizedekig inkább bátor célt, mint valós képességet jelentett. Ekkor az OCR fő megközelítése az volt, hogy a program a beszkennelt betűkből matematikai módszerekkel egy kis “összefoglalót”, egy vektorbeli leírást készített a mérnökök kézzel összeállított instrukciói szerint: a program a betűket egy csontvázzá faragta, meghatározta különféle mértani jellemzőit (hány végpont van benne, hány kereszteződés, hurok), és megmérte, hogy egy-egy adott hálón belül milyen irányú vonalak vannak vagy hány sötét pixel van. Majd ezekből a jellemzőkből tippelte meg a konkrét betűt, különféle statisztikai módszerekkel. Ezt nevezték jellemzőkinyerésnek. A mérnökök által használt statisztikai módszerek a kilencvenes évektől kezdve egyre összetettebbekké, és megbízhatóbbak is váltak, egyre több olyan gépi tanulási módszert használtak, amiket ma az MI-rendelet már igazi MI-nek tekint, pl. Support Vector Machines, Hidden Markov Models módszerek. Aztán az MI fejlődésének hála a 2010-es évek elejére a többrétegű (mély) mesterséges neurális hálók képessé váltak arra, hogy a kézzel készített jellemzőkinyerést kiváltsák.
Az igazán sikeres OCR megoldások 2015-től kezdődően mind többrétegű neurális hálókat kezdtek el használni a karakterfelismerések végett4. Ennek egy fontos példája az eredetileg a HP által fejlesztett, majd a Google által nyílt forráskódúvá tett és továbbfejlesztett Tesseract, amely magyarul is igen jó minőségben érhető el. A Tesseract korábbi változatai a fentiekben leírt kézi jellemzőket nyerte ki, majd a 4. verziótól kezdve a karakterfelismerés az LSTM módszerre tért át. Először egy hagyományos szoftverkönyvtár meghatározza, hogy hol vannak a felismerendő szövegblokkok, vonalak, majd egyenlő magasságú szövegcsíkokra vágja a felismerendő szöveget, és azt szép sorban megeteti a neurális hálókkal: az első (Convolutional Neural Network, CNN) feladata, hogy a pixelekből kiolvassa a betűk éleit és vonásait (a “jellemzőket”), majd az LSTM a jellemzők beolvasása után kiadja a valószínű betűket és szöveget. Látni fogjuk lentebb, hogy már ezek a módszerek is fantasztikusan pontosak, és jó minőségű nyomtatott szöveg esetén egészen minimális hibaaránnyal dolgoznak. A mai számítógépeken már kellően gyorsak, és nagy előnyük, hogy az erőforrásigényük relatíve kicsi, egy-egy otthoni gépen, laptopon is megbízhatóan futnak már, tehát a felismerendő adatokat általában nem kell harmadik felekhez elküldeni felismerés végett.
Rossz minőségű dokumentumokkal vagy neadjisten kézírással ezek az LSTM-alapú OCR-ek is elég nehezen birkóznak meg, akkor is, ha az emberi szem ugyanazt gond nélkül vagy kis gyakorlással ki tudja olvasni. Mondhatjuk ugyan, hogy ilyen esetben a hiba nem az OCR-ező szoftverben van, hanem a szkennelés minőségében, de a napi munkában az nem mindig segít. Érdemes néhány ilyen oldalt megpróbálni elolvasni, hogy mi az a módszer, ami alapján az emberek el tudnak olvasni egy-egy szót, és amire az LSTM módszer nem alkalmas. Egy tipikus ilyen “trükk” az, ha a szövegkörnyezetből ki tudjuk találni, hogy mi lehetett az egyébként olvashatatlan szó, például egy 1915. évi “adás-vevési” szerződésben egy gyakorlott ügyvéd könnyen kiolvassa az “albetét”, “telekkönyvi bejegyzés” vagy “bekebelezés” szavakat, míg egy laikus olvasó nem.
A technikai fejlődés nem állt meg az OCR-ben sem. A többrétegű, mélyneurális hálók közül a legsikeresebb architektúra ma már se nem a CNN, se nem az LSTM, hanem a ChatGPT és társai mögött is működő, a Google által 2017-ben kifejlesztett transzformer típusú architektúra. A nagy nyelvi modellek képességei az OCR számára is újabb frontvonalakat nyitottak. A legújabb, legjobb OCR megoldásokat vizuális nyelvi modelleknek (VLM) nevezik. Az első lépésben egy enkóder típusú modell (ViT = vision transformer) a forrásképet kis képtokenek sorozatává alakítja, majd a következő lépésben ezeket a képtokeneket egy nyelvi modell által is befogadható szöveges beágyazásokká fordítja (az ún. projektor), és végül egy speciális, kifejezetten erre a “fordítási” célra betanított nagy nyelvi modell megkapja a képtokeneket és azt a feladatot, hogy a képi tokeneket alakítsa szöveggé (kb. mindig azt a promptot kapja meg, hogy “írd át az oldalt szöveggé”).
Ezek a modellek már képesek arra is, hogy a szavak és betűk valószínűségének meghatározásakor egy, az eddigieknél jóval szélesebb szövegkörnyezetet vegyenek figyelembe, és ezáltal jóval magasabb minőségű szövegfelismerésre képesek. A régi és kézírásos szövegek olvasásában sokkal-sokkal jobbak, mint az LSTM-modellek. Nagy hátrányuk, hogy az LSTM-hez képest hajlamosabbak egész (hihető!) mondatok hallucinálására, amit viszont jóval nehezebb észrevenni. Nehezebb feladatok esetén hajlamosabbak magukat egy-egy hurokba hajszolni, aminek a vége 100%-ban használhatatlan szöveg lesz. A legkomolyabb hátrányuk pedig, hogy jóval nagyobb teljesítményt igényelnek, mint az LSTM-modellek. Ezen VLM-ek közül a legjobb teljesítményű modellek jó eséllyel egy otthoni gépen nem is fognak elindulni, gyors párhuzamos mátrixfeldolgozást lehetővé tevő egységeket is igényelnek, mint pl. a GPU5, olyan méretű memóriával, amibe a legtöbb ügyvédi irodának nem éri meg befektetni. A megfelelő, a szövegkörnyezetbe tartozó szavak felismerésében természetesen a szakemberekkel nem versenyezhetnek a VLM-ek sem, de itt éppen az a cél, hogy minden felismerésnél minimalizálni lehessen az emberi közreműködést - ezt a munkát senki nem irigyli a mesterséges neurális hálóktól.
Az OCR kísérlet
Illusztrációként nézzünk egy kísérletet. A bevezetőben emlegetett, letöltött adatkészletből és saját gyűjtésből összeállítottam egy kis teljesítményméréshez (“evaluation”) szükséges csomagot.
A csomag részei
jó minőségű HU = GQ_HU
A csomagban van könnyen olvasható, magyar nyelvű jogi szöveg, pl. a NAIH, NMHH és SZTNH PDF-eiből, mintegy 30 oldal. Ezek mind jó minőségű, elektronikusan létrehozott dokumentumok, nem szkenneltek, és a szkennelés szokásos torzításai sem rontják az olvashatóságot (árnyékok, ferde szkennelés, elmozdulás). Ez általában jó indikátora annak, hogy ha valahol egy elektronikus eredetiben készült képnek nincsen szövegrétege, az megsérült vagy a PDF-ben a szövegréteg egyébként a kimásolástól védett, akkor milyen minőségben lehet kinyerni újból a szöveget.
jó minőségű táblázatos = GQ_HU_tab
Érdemes külön megvizsgálni az adatkészlet táblázatainak felismerését, mert a táblázatok felismerése egy sajátos képességet igényel: a mezők sorrendiségének megtartását. Mivel a magyar döntések körében is elég gyakori a táblázatok használata, mind büntetőjogban, mind polgári jogban, erre érdemes külön is odafigyelni.
rossz minőségű HU a döntési adatkészletből = BQ_HU
Aztán van egy fokkal nehezebb szöveg, ami a hirdetményi szerződésekre jellemző - magyarul van, de a szkennelt szöveg nincsen OCR-zve, és ráadásul a hazai ügyvitelre gyakran jellemző, eufemisztikusan szuboptimálisnak nevezhető minőségű, ebből 16 oldal.
régi nyomatok HU = nyomat_HU
Van néhány igazán nehéz dió is, bár ennek a forrása nem a fenti adatkészletem, hanem egy régi gyűjtésem: 11 oldal vegyesen 19. századi nyomatból, 1918-ban és 1919-ben és 1940-ben kötött ingatlan “adásvevési” szerződés, amely egy előnyomott nyomtatvány egy (közelebbről nem beazonosítható foglalkozású) hivatásos által kitöltve, majd egy 1934-ben, 1942-ben és 1958-ban írógéppel készült adásvételi szerződés, mind magyarul.
Savigny_fraktúr
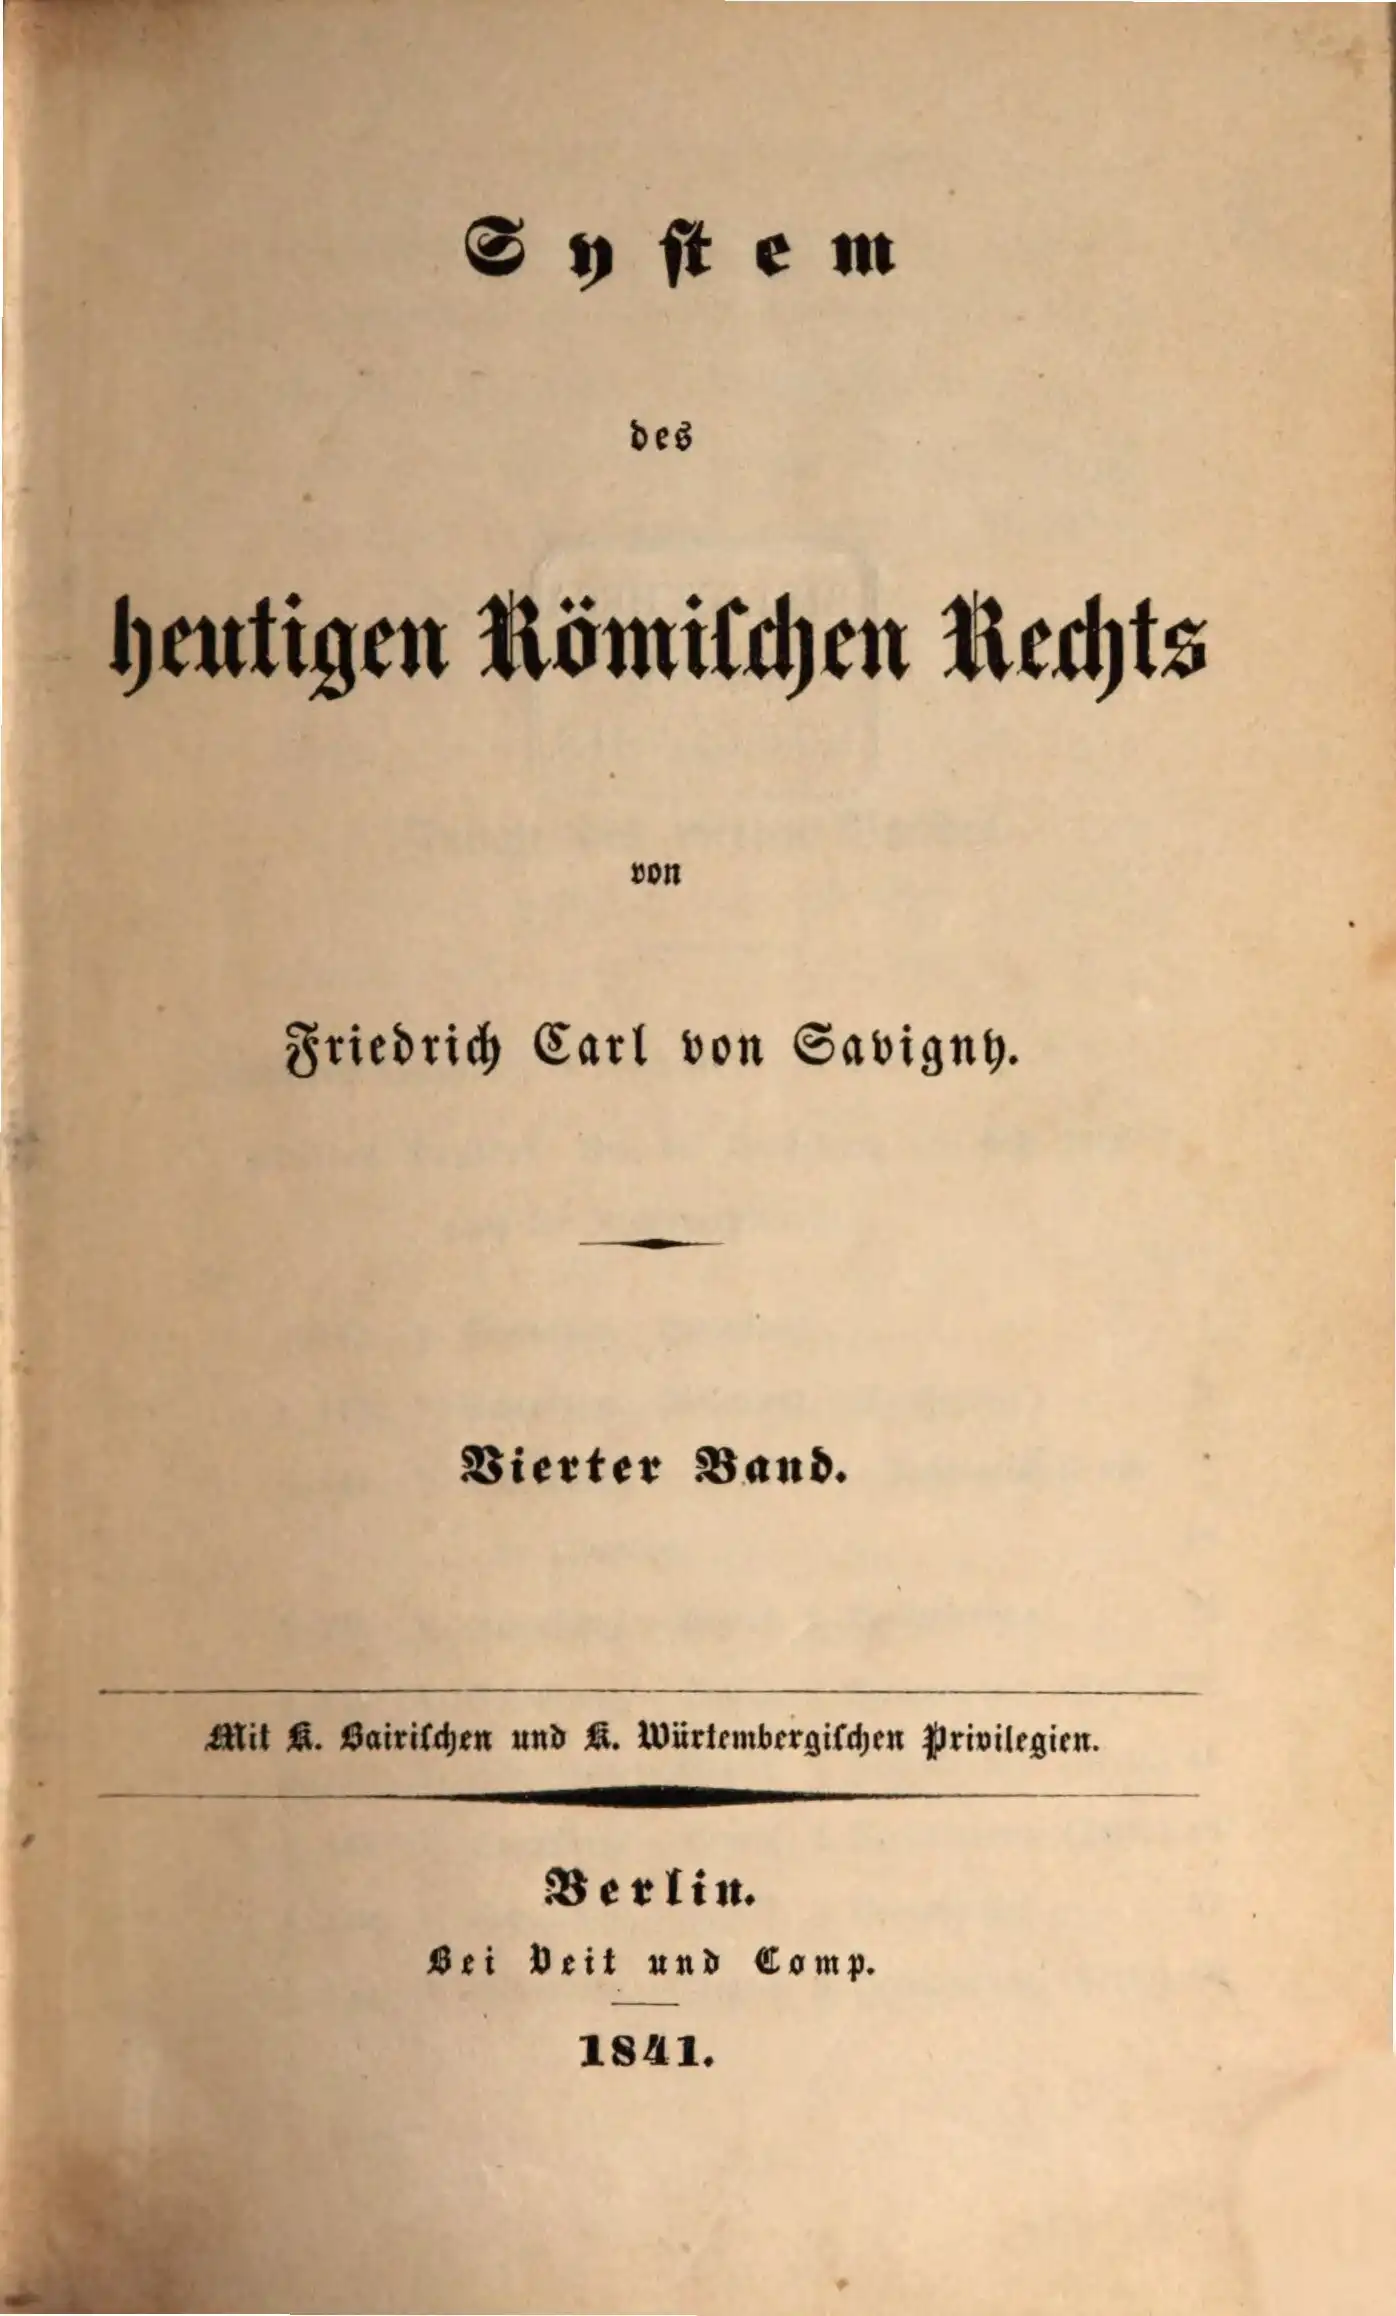
Egy másik nehéz feladat, hogy Friedrich Carl von Savigny 1840-től kezdődően kiadott mesterművének, a “System des heutigen römischen Rechts”-ból kiválasztott 30 oldalt milyen jól ismerik fel a különféle OCR eszközök, beleértve a lapok túloldalán is átütő eredeti fraktúrokat.
HP_hw_hu, HP_hw_en
A legnehezebb természetesen hátravan: a saját kézírásom felismertetése. Sajnos a magyar nyelvű kézírásokból mindössze 3 kész oldalt találtam, de angol nyelvű kézírásból 13 oldalt.
A mutatók
Az eredmények értelmezéséhez három mutatót érdemes használni:
CER (Character Error Rate) azt mutatja, hogy a referenciaszöveghez képest hány karaktert ismert fel tévesen (csere + törlés + beszúrás / referenciaszöveg karakterszáma), pl. a “a vádlott bűnös” helyett az “a vadlott bűnös” esetén az 1:15 arány miatt 6,7% a CER, egy régi kézírás esetén a 10% körüli CER már nagyon jó értéknek számít.
WER (Word Error Rate) a szóhibaarányt mutatja, az előző példa esetén 33% (1/3) a hibaarány.
Ékezethiba aránya (ékezetek cseréje és törlése osztva az összes ékezetes karakter számával).
A használt modellek/OCR eszközök bemutatása
A Tesseract (5) a már említett, ingyenes, nyílt forráskódú megoldás, amely LSTM technikával működik, tehát nem használ vizuális nyelvi modelleket, szinte mindenkinek a saját gépén elfogadható sebességben működik. Van saját magyar nyelvű modellje (van gyors és van jó minőségű, lassabb változata, ez utóbbit használtam), illetve német nyelvű, kifejezetten fraktúr modellje is. Ugyanezen kategóriában kipróbáltam az EasyOCR és a PaddleOCR modellek teljesítményét is, ezek is ingyenesen letölthető, LSTM OCR programok. Ezek előnye a Tesseracthoz képest, hogy elviekben a számítógépben elérhető GPU-t is hasznosítani tudják - de mint láthatjuk, ettől nem lett számottevően gyorsabb.
Kipróbáltam összehasonlításként a ABBYY FineReader Corporate egy régebbi, 15 modelljét is, de az összes tesztoldal lefuttatása indokolatlanul sok időt vett volna igénybe, hiszen itt kézzel kellett volna elindítani a beolvasásokat, majd kiértékelni a végeredményeket, de egy korábbi, jóval kiterjedtebb, de a lenti táblázatokban nem szereplő vizsgálat szerint egyébként sem lett a megoldás minőségének jelentős előnye a Tesseracthoz képest, viszont annál jóval lassabb volt (ez a régi verziónak volt köszönhető). Ezért ezt a szoftvert kihagytam a teljes mérésből.
A fenti, “klasszikus” OCR-ező programokat a saját gépemen futtattam: a Tesseract egy i5-14400F processzoron, az EasyOCR és a PaddleOCR egy GTX 1650 Super videokártyán (de csak 2,7 GB memóriát igényeltek). A Tesseract-tal a fraktúr oldalakon a német fraktúr modellt, a többin a magyart, az angol kézírásnál az angol modellt használtam.
Az újabb generációs, VLM-re épülő megoldások közül a következőket próbáltam ki:
- Qwen3-VL-8B (kb. 8,8 milliárd paraméter): az Alibaba Qwen családjának általános célú látás-nyelvi modellje (VLM), nem kifejezetten OCR-re készült. Kb. 18 GB, 24 GB-os kártyán fut.
- Qwen3-VL-32B (kb. 33 milliárd paraméter): ugyanennek a családnak a nagyobb tagja. Kb. 67 GB, tehát egy 80 GB-os kártyára (pl. NVIDIA H100) már csak éppen elfér, a kényelmes futáshoz egy 141 GB-os kártya (H200) indokolt.
- Qwen2.5-VL-72B (kb. 73 milliárd paraméter): az Alibaba Qwen család előző generációjának legnagyobb tagja. Teljes pontosság mellett kb. 147 GB kellene, ezért a H200-ason is csak 8 bites (fp8) tömörítéssel, kvantizációval futtattam, ami az eredeti modellhez képest kis minőségromlással, de gyorsulással is járt.
- olmOCR-2 (kb. 8 milliárd paraméter): az Allen AI nevű cég kifejezetten dokumentumok szöveggé alakítására finomhangolt modellje, ami a Qwen2.5-VL-7B-re épült. A futtatásához egy 24 GB-os kártya szükséges.
- GLM-OCR (kb. 1,3 milliárd paraméter): a Zhipu AI kisméretű, csak OCR-ezésre szánt modellje. Ez már egy 8 GB-os kártyán is elfér (de a saját kártyám méretét már ez is meghaladta).
A fenti VLM-modelleket egy, a Hyperbolic-nál bérelt, 141 GB memóriájú NVIDIA H200 kártyán futtattam. A teljes mérésben további modellek is szerepeltek (Chandra, Gemma 3, PaddleOCR-VL, HunyuanOCR), de ezek eredményeit itt nem közlöm, mert az eredményeik összességében rosszabbak voltak a többieknél.
Az eredmények
A táblázatokban a “-“ azt jelzi, hogy az adott tesztet az adott programmal nem futtattam le. Az EasyOCR és a PaddleOCR csak a jó minőségű magyar oldalakon lett lefuttatva, a Qwen2.5-VL-72B az egyszerű oldalcsomagon nem futott.
Karakterhibaarány (CER, %, minél kisebb annál jobb)
| program | GQ_HU | BQ_HU | nyomat_HU | Savigny_fraktúr | HP_hw_hu | HP_hw_en |
|---|---|---|---|---|---|---|
| Tesseract | 0,8 | 28,0 | 33,5 | 4,8 | 88,8 | 70,1 |
| EasyOCR | 3,0 | - | - | - | - | - |
| PaddleOCR | 0,4 | - | - | - | - | - |
| olmOCR-2 | 3,6 | 13,5 | 10,1 | 3,2 | 44,6 | 7,5 |
| GLM-OCR | 5,0 | 24,6 | 10,9 | 5,5 | 39,5 | 7,7 |
| Qwen3-VL-8B | 0,6 | 20,3 | 10,5 | 45,6 | 42,9 | 7,2 |
| Qwen3-VL-32B | 0,7 | 18,5 | 10,2 | 4,5 | 39,3 | 14,1 |
| Qwen2.5-VL-72B (fp8) | - | 21,1 | 10,0 | 6,9 | 36,6 | 7,8 |
A Qwen3-VL-8B eredményét egyetlen oldal rontja el, amelyben a modell egy “hurokba került”: ugyanazt a libertinusok házasságával kapcsolatos mondatot ismételgette a végtelenségig. A Qwen3-VL-32B angol kézírásos eredményét hasonló hurkok rontották el.
Szóhibaarány (WER, %)
| program | GQ_HU | BQ_HU | nyomat_HU | Savigny_fraktúr | HP_hw_hu | HP_hw_en |
|---|---|---|---|---|---|---|
| Tesseract | 3,5 | 43,1 | 60,0 | 10,5 | 98,6 | 96,1 |
| EasyOCR | 17,9 | - | - | - | - | - |
| PaddleOCR | 2,6 | - | - | - | - | - |
| olmOCR-2 | 4,6 | 17,1 | 31,4 | 5,7 | 75,2 | 15,1 |
| GLM-OCR | 9,6 | 36,6 | 37,1 | 14,0 | 79,5 | 15,6 |
| Qwen3-VL-8B | 1,5 | 20,3 | 30,3 | 48,9 | 66,6 | 15,1 |
| Qwen3-VL-32B | 1,4 | 22,3 | 28,9 | 7,8 | 62,5 | 19,0 |
| Qwen2.5-VL-72B (fp8) | - | 26,1 | 31,7 | 11,2 | 70,0 | 17,7 |
Ékezethiba aránya (%, csak a magyar nyelvű tesztekre)
| program | GQ_HU | BQ_HU | nyomat_HU | HP_hw_hu |
|---|---|---|---|---|
| Tesseract | 0,2 | 24,9 | 34,9 | 95,7 |
| EasyOCR | 11,3 | - | - | - |
| PaddleOCR | 1,9 | - | - | - |
| olmOCR-2 | 0,5 | 10,9 | 9,5 | 68,7 |
| GLM-OCR | 5,9 | 16,7 | 18,9 | 67,2 |
| Qwen3-VL-8B | 0,3 | 13,7 | 5,7 | 55,9 |
| Qwen3-VL-32B | 0,2 | 13,7 | 6,3 | 49,9 |
| Qwen2.5-VL-72B (fp8) | - | 7,8 | 9,0 | 61,8 |
Táblázatok felismerése (GQ_HU_tab)
A táblázatoknál nem karakter- vagy szóhibát mérek, hanem azt, hogy a felismert szövegben a táblázatcellák hány százaléka egyezik meg a referenciával (cella-F1, minél nagyobb annál jobb), és hogy a modell hány oldalon adta vissza pontosan ugyanannyi sorból és oszlopból álló táblázatot, mint a referencia (12 mérhető oldalból). A klasszikus programok csak sima szöveget adnak, táblázatot nem, ezért itt nem szerepelnek.
| program | cella-F1 (%) | pontos sor-oszlopszám (12 oldalból) |
|---|---|---|
| Tesseract | - | - |
| EasyOCR | - | - |
| PaddleOCR | - | - |
| olmOCR-2 | 85,7 | 6 |
| GLM-OCR | 90,9 | 6 |
| Qwen3-VL-8B | 98,6 | 11 |
| Qwen3-VL-32B | 98,1 | 11 |
| Qwen2.5-VL-72B (fp8) | 94,9 | 9 |
Sebesség
A klasszikus programoknál az egy oldalra jutó idő a saját gépemen mért másodperc. A nyelvi modelleknél az H200 kártyán mért teljes futási időt osztottam az oldalak számával (a modellek egyszerre 8 oldalt dolgoztak fel, a modell betöltésének ideje nélkül, ami modellenként még néhány perc volt), ezért a két csoport számai nem hasonlíthatók össze egy az egyben. A Qwen3-VL-32B lassabbnak látszik, mert néhány oldalon a modell hurokba került, és a megengedett leghosszabb kimenetig írt.
| program | hardver | GQ_HU (mp/oldal) | az összes teszt (mp/oldal) |
|---|---|---|---|
| Tesseract | processzor | 3,7 | 2,7 |
| EasyOCR | GTX 1650 Super | 5,5 | - |
| PaddleOCR | GTX 1650 Super | 2,8 | - |
| olmOCR-2 | H200 | 1,2 | 1,2 |
| GLM-OCR | H200 | 0,7 | 0,5 |
| Qwen3-VL-8B | H200 | 1,7 | 2,8 |
| Qwen3-VL-32B | H200 | 4,9 | 8,4 |
| Qwen2.5-VL-72B (fp8) | H200 | - | 5,2 |
A referenciákról
A fraktúr oldalak referenciája a Deutsches Textarchiv gondosan ellenőrzött átirata. A jó minőségű magyar oldalaké a PDF-ek saját szövegrétege, a táblázatoké a PDF-ből gépileg kinyert táblázat (ezt kézzel nem ellenőriztem). A régi nyomatok referenciája egy korábbi OCR-program szövegrétegéből indult, a hirdetményi szerződéseké a Tesseract kimenetéből, és mindkettőt kézzel javítottam végig (a régi nyomatok egyik oldalát, egy kézzel írt szerződést, először egy nyelvi modell írta át, azt javítottam). A kézírásos oldalak átírását is először egy nyelvi modell készítette el a képekről, és én javítottam ki sorról sorra (a magyar kézírásnál ez sok javítást jelentett, az angolnál alig). Mivel a javítást egy nyelvi modell első átirata alapján végeztem, a referencia kissé hasonlíthat a nyelvi modellek tipikus olvasatához, ezért a kézírásos tesztek számaira érdemes közelítő értékként tekinteni.
Néhány megfigyelés
- Egyszerű, jó minőségű magyar oldalakon (GQ_HU) a Qwen3-VL modellek és a klasszikus PaddleOCR és Tesseract is 1% alatti karakterhibával dolgoznak. A szóhibában a Qwen3-VL modellek (kb. 1,5%) a klasszikus programok (2,6-4,6%) elé kerülnek.
- A nehezebb, szkennelt, régi vagy kézírásos anyagokon a klasszikus programok sokkal rosszabbak: a hirdetményi szerződéseken 28% a Tesseract karakterhibája, a magyar kézírásnál már a szavak közel 100%-át elrontja.
- Nincs egyetlen nyertes: az olmOCR-2 a nyomtatott és szkennelt oldalakon a legjobb (beleértve a hirdetményi szerződéseket is), a Qwen3-VL a táblázatokban, a legnagyobb modell (72B) a magyar kézírásban és a régi nyomatokban. Az utóbbi előnye láthatóan kicsi, és a teszt mindössze 3 magyar kézírásos oldalon alapul.
- A magyar kézírást még a legjobb modellek is csak kb. 37-45%-os karakterhibával olvassák, és a hibák jó része hihetően hangzó, de a lapon nem szereplő szöveg (például a “gépjárműgyártás, adóeljárás” helyett “gyermekkort, adóeljárás” kerül a szövegbe), amit olvasáskor nehéz észrevenni. Régi kézírások nagy tömegű feldolgozása esetén indokolt erre a célra dedikált, fizetős modelleket használni (mint pl. a Transkribus).
Összefoglalásként: láthatjuk, hogy az extrém, kézírásos eseteken kívül nyugodtan mindenki használhatja az ingyenesen elérhető legjobb magyar Tesseract modelleket. A drágább, VLM-re épülő OCR-t a nagyon nehéz dokumentumoknál érdemes csak használni, mint amilyenek a kézírások feldolgozása vagy a nagy mennyiségű, olvashatatlan dokumentumok javítása. Ezen túl pedig jó szívvel javasolhatom a használatát minden olyan szervezetnek is, ahol még mindig szokás a kinyomtatott iratborítókra kézzel írni, pl. irodai utasításokat.
A Microsoft saját, nyilvános specifikációja az eltérő szövegfeldolgozó eszközök közötti dokumentumcserék könnyítésére. ↩
A Microsoft által benyújtott, de a szabványügyi szervezetek által közzétett nyilvános szabvány, ISO/IEC 29500. ↩
A Portable Document Format egy nagyon sokoldalú oldalleíró nyelv és adattárolási formátum, amit az Adobe Inc. fejlesztett ki, majd 2008-ban ISO 32000 néven szabványosították. A sokoldalúsága miatt szinte lehetetlen elvárás, hogy egy-egy PDF-olvasó minden változatát tökéletesen kezelni tudjon. ↩
A tipikus módszer ekkor az ún. Long Short-Term Memory (LSTM) neurális háló volt. Európaiként érdemes megjegyezni, hogy az elméletet 1997-ben két német kutató, Jürgen Schmidhuber és Sepp Hochreiter dolgozta ki, lehetővé téve, hogy a neurális hálók bizonyos méret és bonyolultság felett se feledjék el a korábban tanultakat. Azonban úgy 2012-ig a számítógépek nagy többsége nem volt elég erős az algoritmus használatához, kipróbálásához. Amikor azonban 2012-ben számos nyelvfeldolgozási területen átálltak erre a módszerre (így a hang- és a szövegfelismerés, fordítás terén is), az forradalmi minőségjavulást jelentett. ↩
Graphics Processing Unit, de ebbe a kategóriába lehet sorolni még a fogyasztók számára kevésbé látható, Google-féle Tensor Processing Unitokat is. ↩

