Az előfeldolgozás és adattisztítás
A korábbi blogbejegyzésben leírtak alapján szöveggé tudtuk alakítani a képeket (OCR), és a szövegréteg nélküli dokumentumokat is. Most már semmi sem tarthat minket vissza attól, hogy az óriási adatkészletet hasznosítsuk, ugye?
Akár most is elkezdhetnénk keresni az adatokat, és a legtöbb esetben valószínűleg észre sem vennénk a különbséget, hiszen annyi döntésről van szó, így azonnal valamifajta, látszólag használható eredményt fogunk kapni. De éppen ez a csapda: ha alaposabban belenézünk sok-sok döntésbe, vagy csak megfelelő alapossággal különféle elemzéseket végzünk rajtuk, látni fogjuk, hogy a letöltött adatkészletek közül sok hemzseg a hibáktól, és ha így kezdjük el használni a rendszerünket, az előbb-utóbb kihatással lesz az eredményekre is.
Ezért fontos kitérnünk az adattisztításra, az előfeldolgozásra és a tesztelésekre, kiértékelésekre. Ez a blogposzt részleteiben az adattisztításra fog fókuszálni, az előfeldolgozás (az adattisztításnál bővebb) jelentéséről is röviden írok. Semmiképpen nem tűnik egy izgalmas témának, de enélkül esélyünk sincs megérteni, hogy mi is az adatközpontú jogászi munka előfeltétele. Ne feledjük, hogy a szoftverek és jogi adatbázisok kiadóinak ez az egyik legkomolyabb feladata, amiből itt csak egy ízélítőt próbálok mutatni.
Az előfeldolgozást nevezzük most egy tágabb fogalomnak: a célja az, hogy egy rendelkezésre álló adathalmazt, így a döntések szövegét olyan formába hozzuk, hogy az minél inkább alkalmas legyen egy-egy konkrét célra, pl. a hétköznapi jogi munkával kapcsolatos keresésre vagy valami nyelvi modellezésre, elemzésre (pl. kártérítési összegek vagy a perköltségek megítélésével kapcsolatos joggyakorlat elemzése).1 Ha a célom a kártérítési összegek elemzése, akkor nem gond, ha pl. a magyar ítéletekben lévő cirill vagy görög betűs szövegek nem olvashatóak, de fontos a számok egységes megjelenítése, a tizedesjegyek elválasztása és a hármas számcsoportok szerinti egységes tagolás. Ellenben, ha az ítéletekben idézett vádlotti “gondolatokat” kívánjuk pontosan visszaadni, akkor követünk el hibát, ha nyilvánvaló helyesírási hibákat is javítjuk. Ha a célunk az, hogy egy idézett döntésből oldalszámra hivatkozva is idézzünk, akkor az oldalak tördelését sem változtathatjuk meg, de az elemzések esetén az oldalszámok, sőt a sorok közötti elválasztások is csak zavaróak, rontják az elemzés pontosságát, mert pl. nem találja majd meg a gép a “vád- | lott” jellegű, új sorba tördelt esetekben azt, hogy itt valójában a mondatban a vádlottról volt szó.
Általában az adattisztításról
Ha meg kívánjuk őrizni a letöltött adatkészletek minél sokoldalúbb használatának lehetőségét, nem volna szabad a szövegünket egy-egy konkrét felhasználási célra leszűkíteni. Ezzel szemben az adattisztítás célja pusztán az, hogy kiszűrjük azokat az adathibákat, indokolatlan eltéréseket, és a hiányzó adatokat, amelyek rontják a várható eredményt. Az adattisztítást tehát az előfeldolgozás tágabb fogalmán belül egy önálló lépésnek tekintik (a konvertáláson és a különféle forrásból származó adatok integrálásán stb. mellett), és a fő célja, hogy az adatok közötti “indokolatlannak” tekintett eltéréseket vagy hibának tekintett jelenségeket megszüntesse.
A helyesírási hibák javításával kapcsolatos fenti példából láthatjuk, hogy még az adattisztítást sem lehet “csak úgy” elvégezni, függetlenül attól, hogy mi a cél, amire a tisztított adatokat használni szeretnénk. Például, ha az eredeti szöveg oldalakra tördelését elhagyjuk, és a szövegbe beleírt oldalszámokat töröljük, akkor nem fogjuk tudni többé megmondani, hogy egy-egy idézni kívánt rendelkezés az eredeti döntés hányadik oldalán szerepelt. Más szempontból nézve azonban az ilyen oldalszámok vagy a kézi sortörések, oldaltörések igen zavaróak az olvasásban, legyen szó akár gépi vagy emberi szövegértésről.
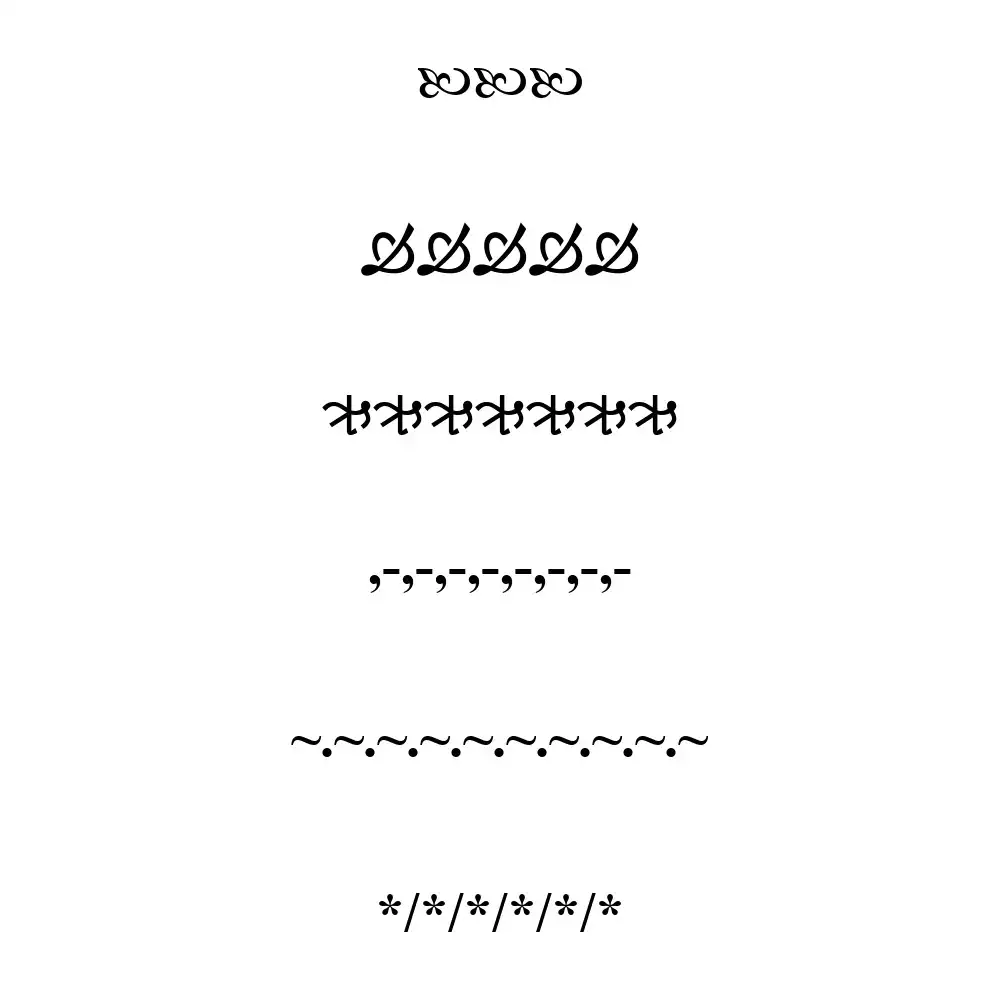
Más esetben az adatelemzés túlmutathat a tipikus jogászi vizsgálatok körén, és az adattisztítás céljának is ezt figyelembe kell vennie. A rendelkezésre álló adatmennyiség mellett egészen jól ki lehet bányászni a BHGY-kból, hogy az egyes bíróságok milyen sablonokat osztottak meg egymással, vagy a BHGY-t kiadó szerv miként változtatta az átalakító vagy anonimizáló szoftverének beállításait az idők során. Olyan roppant hasznos információkkal lehetünk gazdagabbak, hogy az ítélet egyes szerkezeti elemeit (pl. rendelkező rész, perköltségről rendelkezés) elválasztó kézi díszítősorok száma az utóbbi években jelentősen csökkent. Korábban Székesfehérváron a ,-,-, és a ~.~. volt népszerű, míg Tatabányán a */*/, Kaposváron pedig a -/-/. A legfeltűnőbb díszítősor a Miskolci Járásbíróság egy bírója két döntésében használta 2014-ben és 2015-ben. Ezekben a gudzsarati nyelv “ru” magánhangzója (ઋ, Unicode U+0A8B) sorakozik egymás után, természetesen csak dekoratív célokból. Hogy miért, azt valószínűleg soha nem fogjuk megtudni, de könnyen lehet, hogy mindez csak a műszaki véletlenek összjátéka. (A bírósági díszítósorokat választottuk e poszt fedőképeként is.)
Az ellenőrzések során figyelni kell arra, hogy egy kisebb példányszámú adatkészlet esetén számos hibára nem derül fény, azaz tíz döntés ellenőrzése természetesen egészen más módszereket és hangsúlyokat igényel, mint éppen tíz- vagy százezer döntés.
Mi miatt szükséges adattisztítani?
Az előző blogbejegyzésben megvizsgáltuk, hogy a szövegréteg nélküli döntésekből hogyan tudtunk szöveget kinyerni. Ez alapvetően a hirdetményi földügyi szerződések adatkészletét érinti (20% esetén nincsen ilyen réteg), az NKFH néhány döntését (0,8%), valamint az SZTNH által közzétett szakértői döntések 5%-át. Minden OCR-zett szöveg esetén számítani kell karakterhibákkal is, akár mi magunk, akár a kiadó végezte el az OCR-zést (pl. a BHGY-k esetén is vannak OCR-zett karakterek, nem csak az eredeti forrásfájlból kinyert szövegek). Vannak tipikus vagy egy-egy szkennerberendezésre, OCR-ező programra vagy szkennelési szokásra jellemző hibák is, pl. a betűn belüli szóközök vagy a több szó összevonása, az n/r, ö/ő, i/r betűk vagy az “li” kettősbetű (ligatúra) és a t összekeverése, vagy Canon másolók esetén gyakori ó és ő cseréje (“szerzódés”, “eladő”) stb.
Számos, súlyos hibát okozhatnak az egyes fájlformátumok közötti konverziók is. Például 2019-ig szinte minden döntés a BHGY-ben ún. RTF (Rich Text Format)2 típusú, 2021 óta pedig szinte mind a Word-ben használt .docx,3 azaz OOXML formátumú. Emiatt az eddig közzétett döntések több mint 68%-át úgy kell átalakítani szöveggé, hogy ne lépjen fel komoly adatvesztés vagy torzulás, ami még a legújabb agentikus keretrendszereknek sem triviális feladat. Ezen túl az anonimizálást végző eszközök4 is rendszeresen okoztak kisebb adathibákat. Erre már 2019-ben felhívta a figyelmet Görög György és Weisz Péter is: az általuk feldolgozott jogi szövegforrások is szkennelési és OCR-hibáktól, valamint a túlbuzgó anonimizálás miatti súlyos adatvesztéstől szenvedett.5
Az RTF-ek átalakítása során az alábbi tanulságokat figyelhetjük meg:
a) A pandoc-nevű eszköz használata során elveszik a táblázatok tartalma, valamint igen lassú, ezért az ilyen gyors átalakításhoz érdemes egyedi fejlesztésű átalakítókat létrehozni (ami figyel az alábbiakban említett egyes hibákra is).
b) A döntések sokfajta eltérő karaktert használnak, legyen szó a magyar nyelvben tipikus ékezetekről, a magyar nyelvű szövegbe beiktatott görög és cirill karakterekről (pl. találhatunk ukrán-magyar nyelven közzétett, kétnyelvű idegenrendészeti jellegű bírói döntést is). A karakterek kódolása az RTF esetén nem olyan egyértelmű, mint pl. a .docx vagy a szövegfájlok esetén. Itt ugyanis a használt karaktereket különféle kódtáblák szerint jelölik meg, nem az egységes, 1991-ban elfogadott, de csak fokozatosan elterjedt Unicode szabvány szerint (ami az írásfajtától független egységes karaktertáblázatot alkot). A kódtáblát meg lehet adni az egész szöveg, a használt betűtípusok és az egyes karakterek szintjén is, és a módszerek eltérése gyakran okozhat problémát. Pl. ha az egész szöveget úgy jelölik meg, hogy az nyugat-európai karakterkészletet használ (cp1252), de a betűtípusnál már közép-európait adnak meg, csak ez utóbbi megjelölést nem rögzítik, akkor ez hullámos õ és kalapos û karaktereket fog mutatni. Vagy fordítva: közép-európai szövegben a nyugat-európai egykarakteres 1/4 (¼) szlovák hacsekes L-betűvé (Ľ) válik, és csak a szövegkörnyezetből lesz egyértelmű, hogy itt milyen betűt is kellene használni. Több mint 600 döntés esetén a § és az anonimizálási célú, egy karakterben megjelenő “…” jelet japán (Shift-JIS) karakterkódolással rögzítették. Előfordulhat, hogy a leíró bemásol egy olyan szöveget, amiben számára nem látható módon belekerül egy arab szöveget meghatározó karakter (irányváltással együtt), ami csak átalakításkor válik láthatóvá, és az ékezetes betű arab betűvé változik (“… fizessen meg az لllamnak külِn …”). Végül olyan helyzet is van, ahol a kinyomtatott betű formájából lenne csak egyértelmű, hogy itt nem arról a betűről, hanem valamifajta grafikus jelről volt szó, mert pl. a Wingdings betűtípust használták, és azon belül a jobbra mutató nyíl hacsekes R-ré vált (Ř). Ilyen hiba néhány ezer döntést érintett.
c) Előfordult, hogy a tabulátorhoz hasonló ún. kontrollkaraktereket (\tab, illetve \qj, ez utóbbi a sorkiegyenlített bekezdésigazítás) az OBH által használt eredeti átalakító program nem választotta el a következő szótól, így \qjDr, \qjBudapest, \tabSzentendrei szövegek jöttek létre. Ezeket azonban sem a Word, sem más alkalmazás nem jeleníti meg, hiszen nem létezik ilyen kontrollkarakter. Az átalakításkor az ilyen hibákat is figyelembe kell venni, ez a döntések 28%-át érintette, csak a legtöbb esetben láthatatlan volt (mert pl. senkinek nem volt olyan kérdése eddig, hogy a bíró doktor volt-e vagy sem).
Ezzel szemben PDF-ek6 esetén másfajta hibákkal találkozhatunk: véletlenül, a szavakon belül egymástól elválasztott karakterekkel (“rendelk ezése”), mert a PDF a szöveget is gyakran “rajzolja”, a betűk egymáshoz képest meghatározott pozicionálása ilyen hibákat okozhat.
Természetesen nem csak átalakítási hibákat találhatunk, hanem már a bíróság által létrehozott forrásszöveg is rejthet hibákat. Például az összes közzétett döntés közül 1.546 döntésben 2.381-szer szerepel a “felepres” szó, 1.251 fájlban 1.520-szor a “konjuktív”, és 923 döntésben a “felbújt” különféle származéka… Érdekes kérdés, hogy a BHGY-k alapján mit tartsunk a metiléndioxi-metamfetamin szer meghonosodott megjelölésének, ha egyszer 5.512-szer szerepel az “extasy” és csak 3.212-szer az egyébként helyesírási szempontból helyes “ecstasy” változat. Fontos fejben tartani azt is, hogy van számos olyan jogi műszó, amelyeket egy-egy hagyományos helyesírás-ellenőrző eszköz hibaként jelöl meg, mint a “védirat”, “szúrcsatorna” vagy az “érintetti” kifejezés.
Az egyes adathibák az adatkészletekben
Az egyes adatkészleteket nézzük át a fenti hibák szempontjaiból (az egyes rövidítések feloldását lásd a korábbi blogbejegyzésben).
| Jelenség | fegyelmi | hird. szerződés | AB | NKFH | GVH | domain.hu | SZTNH | NAIH | BHGY |
|---|---|---|---|---|---|---|---|---|---|
| Wingdings/szimbólumbetűtípus karakterei (ikonok, felsorolásjelek) | 0% | 0% | 0% | 67% | 3% | 0% | 2% | 2% | 4,4% |
| Hibás kódlap | 0% | 0% | 0% | 0% | 0% | 0% | 0% | 0% | 0,27% |
| Hullámos vagy kalapos õ vagy û a hosszú ő, ű helyett | 0% | 0% | 0,5% | 0% | 0% | 5,5% | 0,5% | 0% | 0,67% |
Az oldalszámokat, a ritkított írást és a kézi sortöréseket lent, a normalizáció kérdései között vesszük sorra.
Hogyan vegyük észre az adathibákat?
Ha új szöveges adatkészlettel találkozunk szembe, komoly kérdés, hogy milyen módszerekkel mérjük fel az előttünk álló szöveg hibáit, akár át kell alakítanunk, akár nem. A hibákat nekiállhatunk keresni karakterek, szavak, sorok vagy egész fájlok (döntések) szintjén, illetve már előre csoportosíthatjuk a vizsgálandó szöveghalmazt valamilyen ismert forrás vagy módszer szerint, hiszen a hasonló szövegforrások és technikai műveletek esetén a tipikus hibák is hasonlóak szoktak lenni.
Az ideális az lenne, ha lenne egy referenciaszövegünk, miszerint egy “helyes” szövegnek hogyan kell kinéznie. A referenciaszöveg méretétől és sokféleségétől függően megkereshetjük sajátos jellemzőit, amiből megpróbálhatunk általános szabályokat, jellemzőket levonni. Ilyen lehet pl. karakterszinten az, hogy magyar szövegekben milyen karakterek szoktak milyen arányban előfordulni, milyen gyakorisággal. Vagy az, hogy mi a tipikus szóhossz, sorhossz. Ha az adatkészletben néhány szöveg ettől nagyban eltér, akkor közelebbről is megvizsgáljuk a szöveget. Aztán készíthetünk egy jó nagy listát a tipikus szavak szótöveiről is, és a teljes szöveg minden szaván végigfuttathatjuk a szótövező (lemmatizáló) programot, és kijelöljük további vizsgálatra azokat a határozatokat, ahol az átlagosnál vagy az adott határozattípusnál kiugróan nagyobb a szótáron kívüli szavak aránya.
A magyar szakirodalomban találhatunk további érdekes módszereket is, amelyek segítenek az adatkészletekben található zajok észlelésében. Ilyen például egy közzétett karakteralapú nyelvi modell,7 amelynek segítségével a szavak adott kontextusbeli szokatlanságát, perplexitását mérik, ami a szöveghibák megtalálásában is segíthet, bár korlátokkal. A BHGY 10%-ának felmérése után azt láttam, hogy a normál szövegsor perplexitásának mediánja 1,19, ám az elválasztó díszítősorok perplexitása egymillió, az anonimizációs címkéket tartalmazó soroké 300–400, míg a durva OCR-hibák csak 100 körüli értéket mutatnak.8 Emiatt ez a módszer az elírások, betűhibák kiszűrésére csak mérsékelten alkalmas, főleg akkor, ha előtte kiszűrjük (maszkoljuk) a normális esetben is kiugró értékeket, pl. az ügyszámokat, szóközzel széthúzott szavakat. A 10%-os mintában a karakterszám szerint súlyozott átlagos pontszám 1,29 lett, és ebből két döntés lóg ki nagyon: a Kúria 2011. évi Kfv.II.37.605/2010/4. számú ítélete (végzése?), amely csak az ügyszámot teszi közzé, és a Fővárosi Törvényszék 43.B.44/2022/45. számú bűnügyi ítélete, amelyben költségvetési csalás bűntettében két év szabadságvesztésre ítélte a terheltet, és (akár a büntetés részeként) az ítéletben 950 oldalon felsorolta azt is, hogy a vádlott három év alatt milyen sorszámú és értékű számlát állított ki, aminek az áfáját nem fizette be. A karakteralapú nyelvi modellt közzétevő kutatócsoport egy későbbi cikkében ezt az eszközt használta arra, hogy eltérő OCR-modellekkel készült változatokat vetettek össze, és ahol a változatok eltértek, ezen nyelvi modell választotta ki a valószínűbbnek mutatkozó helyes megoldást.9
Ez a karakteralapú LSTM-modell nem jelent minden adathibára gyógyírt, de hasznos kiegészítője a magyar nyelvű jogi szövegek elemzésének is. A teljes BHGY-n (6 milliárd karakteren) való végigfuttatása egy otthoni-irodai kategóriás, GPU-val rendelkező eszközön kb. 60–130 órát vesz igénybe, de a teljes BHGY készlet futtatása még egy méregdrága H200-ason is több órát vesz igénybe.
Az adattisztításon túl: normalizáció, kanonizáció
Mindig találkozhatunk olyan sajátosságokkal is, amelyek esetén el kell dönteni azt is, hogy a módosítás kívánatos-e vagy sem. Például a határozatok 77,5%-ában szerepelnek szóközökkel ritkított szavak, mint az “Í T É L E T E T” vagy “I N D O K O L Á S”, és nem feltétlenül következetesen vagy hibátlanul alkalmazva.
Általában nem azt kívánjuk elemezni, hogy melyik leíró, írnok vagy bíró tudja jól használni az olyan alapvető Word funkciókat, mint pl. az oldaltörés vagy a középre igazítás, és nem szóközökkel és az Enter sűrű nyomogatásával oldja meg. A ritkított írás egy ilyen adatkészletben már az eredeti vizualizációs célt nem szolgálja, cserébe viszont igencsak megnehezíti a további automatizálást: pl. gyakran hibás lesz a szófelismerése (“I n d o k o 1 á s”), nem működnek rajta a helyesírásellenőrzők stb.
Éppen ezért általában kívánatos az olyan plusz jelek törlése, mint a sorkezdő, sorvégi vagy dupla szóközök, vagy a sorok és a bekezdések közötti távolságok “beállítását” célzó sortörések, a tabulátorok, a fájlok végén található NUL-karakterek (amelyek csak fölöslegesen foglalják a helyet, és mégis, a BHGY döntések közel 5%-át érinti).
Egy másik ilyen kérdés a feltételes elválasztás vagy a szövegbe épített oldalszámozás kezelése vagy fejléc információ (ügyszám), illetve a kézi sortörés minden sor végén.
Hasonlóan az automatizálást kívánják elősegíteni az egyes normalizációk is, amikor valamilyen írásjelet vagy szövegbeli szerkezeti egységet egy kanonikus (normálformára) hoznak. Pl. biztosítják, hogy a különféle idézőjeleket egy adott szabály szerint használják a teljes adatkészletben (egyenes, az alsó ún. kilences „ és felső hatos “ vagy kilences ”, a lúdlábak « » stb.), vagy a két jelből is összeállítható Unicode karaktereket egy karakter jelölje.10 Hasonló lépésekkel, azaz a feltételes elválasztójelek törlésével, a sorvégi elválasztások összevonásával, az idézőjelek egységesítésével és a többszörös szóközök összevonásával készítették elő a szöveget Laki László és szerzőtársai is, amikor neurális modellekkel igyekeztek az OCR-hibákat javítani.11
Szintén a BHGY-döntéseket nézve láthatjuk, hogy az anonimizált adatok jelzése igen heterogén: tanú1 vagy tanu1, név4, cégnév1, személy5, helység1, telefonszám1, de lehet, hogy különféle hosszúságú és keretezésű pontokat használtak (“….”, “……”, “(…)”) vagy betűvel jelölt kezdőbetűket (“XY”, “X. Y.”, “A. B.”), “xxxxx”. Elég gyakran megmaradtak a különféle toldalékok (pl. Ivettel szóból lesz “nevetel”). Mindez megnehezíti az automatikus feldolgozást, pl. a mondatokban szereplő egyes szavak szerepének beazonosítását vagy a szövegbeli szerepkörök beazonosítását és az ahhoz kötött további elemzéseket (ún. “Named Entity Recognition” vizsgálatokat). Az anonimizálás jogi és technikai nehézségeit, magyar bírósági példákon is, Csányi Gergely és szerzőtársai foglalták össze.12.
A fenti tisztítások és normalizációk nélkül a szöveg nyelvtani mondatokra való szétválasztása és elemzése is nehezebben, kevésbé jó minőségben fog sikerülni. Egy szövegbeli sor természetesen több mondatot is tartalmazhat, csak éppen a mondatvégi pontokat nem olyan egyszerű elkülöníteni a különféle ismert hétköznapi és jogi rövidítésektől, és a nagy kezdőbetű sem ad megbízható megoldást. A bírósági határozatok mondatokra bontásának feladatát a magyar szakirodalomban is már többen megvizsgálták, ki kell emelnem Csányi és szerzőtársainak alapos művét.13
| Jelenség | fegyelmi | hird. szerződés | AB | NKFH | GVH | domain.hu | SZTNH | NAIH | BHGY |
|---|---|---|---|---|---|---|---|---|---|
| Feltételes elválasztójel (lágy kötőjel) | 0% | 0% | 23% | 0% | 0% | 1% | 0% | 0% | 0,7% |
| Sorvégi elválasztással kettévágott szavak | 0% | 27% | 0% | 24% | 22% | 4% | 15% | 28% | 1% |
| Ritkított írású szavak | 0% | 0,6% | 49% | 81% | 28% | 0,5% | 7% | 26% | 77,5% |
| Oldalszámok a szövegben | 0% | 95% | 0% | 97% | 32% | 17% | 36% | 86% | 2% |
| Kézi sortörés (rögzített szélességű tördelés) | 0% | 7% | 0% | 95% | 24% | 55% | 78% | 96% | 0,09% |
Összefoglaló
Láthatjuk, hogy az adatok alapos, magas színvonalú előfeldolgozása minden további jogi munkának is előfeltétele. Ha kevésbé megbízható a szkennelt szöveg, a sortörések és a mondatok felbontása, az anonimizált alakok normalizációja, akkor sajnos ez a jogi munka automatizációját is megnehezíti, rontja azok eredményét.
Ha magunk látunk neki az adattisztításnak gépi segítséggel, figyeljünk arra, hogy ne töröljük az eredeti szöveget az adattisztítás végleges változatának jóváhagyásáig, mert számtalanszor vissza kell térni majd az előző változatokhoz, ha kiderül, hogy rossz döntést hoztunk. A fenti útmutatás alapján értsük meg, hogy milyen szövegből áll a megszerzett adatkészlet, milyen formátumokban áll rendelkezésünkre az adatkészlet, milyen karakterkészleteket használnak, és milyen jellegű szöveg várható. Az átalakítást és a hibakeresést is tervezzük több körös műveletként, és az észlelt hibák okának mindig próbáljuk meg utánajárni. Több százezer döntés mellett a kézi adattisztítás, a kézi normalizáció egyszerűen nem opció.
Az adattisztítás művelete azért is fontos, mert ezzel jobban megismerjük az adatkészlet egyes jellemzőit, típusait anélkül, hogy mind a kétszázezer döntést el kellene olvasnunk. Megtalálhatjuk a leghosszabb és a legrövidebb ítéleteket, rátalálhatunk a BHGY-ban elrejtett húsvéti tojásokra és kakukktojásokra, mint a 7.000 közigazgatási határozat (ezek a bíróság által felülvizsgált hatósági döntések, amelyeket a bírósági határozat mellé, külön fájlként tettek közzé), vagy az anonimizálás ellenére benn maradt személyes adatok.
Az adattisztításnak köszönhetően azonban már bátran nekivághatunk a következő résznek: milyen módszerekkel és feltételekkel tudunk jogi szövegekben hatékonyan keresni (“információvisszakeresésről jogászoknak”).
Az adattisztításhoz használt eszközöket, a lépések általános, technikai leírását és az ellenőrzött szólistákat közzétettem a GitHubon. Megtalálható például a jogi szövegekben helyes (vagy még az előző helyesírási szabályzat alapján helyes), de a Hunspell helyesírás-ellenőrző által nem ismert vagy hibásként jelölt 359 szó, a bírósági határozatokban talált 846 rövidítés a jelentésével, valamint 127 gyakori elírás és OCR-hiba a javításával. A letöltött és megtisztított döntések, valamint a karakteralapú nyelvi modellel végzett pontozások nincsenek közzétéve.
Jiawei Han, Micheline Kamber, Jian Pei: Data Mining: Concepts and Techniques, 3. kiadás, Morgan Kaufmann, 2012, 85–86. oldal. ↩
A Microsoft saját, nyilvános specifikációja az eltérő szövegfeldolgozó eszközök közötti dokumentumcserék könnyítésére. ↩
A Microsoft által benyújtott, de a szabványügyi szervezetek által közzétett nyilvános szabvány, ISO/IEC 29500. ↩
Feltételezzük, hogy az OBH által használt anonimizáló szoftver neve vagy megjelölése AKH4T. Az anonimizálásról lásd Gyarmathy Judit: A bírósági határozatok közzététele a digitalizáció összefüggéseiben, Infokommunikáció és Jog, 2024/2. (83.), 18–22. oldal. ↩
Görög György, Weisz Péter: Legal entity recognition in an agglutinating language and document connection network for EU Legislation and EU/Hungarian Case Law, arXiv:1907.12280, 2019, 1. oldal. ↩
A Portable Document Format egy nagyon sokoldalú oldalleíró nyelv és adattárolási formátum, amit az Adobe Inc. fejlesztett ki, majd 2008-ban ISO 32000 néven szabványosították. A sokoldalúsága miatt szinte lehetetlen elvárás, hogy egy-egy PDF-olvasó minden változatát tökéletesen kezelni tudjon. ↩
Pethő Gergely, Sass Bálint, Simon László, Lipp Veronika: Korpusztisztítás és sorvégi kötőjelek kezelése karakteralapú neurális nyelvmodellel, in: Berend Gábor, Gosztolya Gábor, Vincze Veronika (szerk.): XIX. Magyar Számítógépes Nyelvészeti Konferencia (MSZNY 2023), Szegedi Tudományegyetem, Szeged, 2023, 291–304. oldal. A betanított modell a GitHubon letölthető. ↩
Például a “éííööáéöÉőíéöéa budapesti xx.,” szöveg értéke csak 119, noha emberi ránézésre feltűnően “furcsa”. ↩
Pethő Gergely, Sass Bálint, Simon László, Lipp Veronika: OCR-hibák kvantitatív elemzése több szövegváltozat összehasonlításával, in: XX. Magyar Számítógépes Nyelvészeti Konferencia (MSZNY 2024), Szegedi Tudományegyetem, Szeged, 2024, 17–29. oldal. A cikk két mellékes megállapításával nem értek egyet. A szerzők a Tesseract magyar nyelvű modelljét rövid tesztelés után használhatatlannak találták (20. oldal), de az előző bejegyzésben bemutatott mérésben a Tesseract jó minőségű magyar oldalakon 1% alatti karakterhibával dolgozott. Megjegyzem, hogy 2023-ban a ChatGPT-vel végzett javítás költségét az akkori árakon is nézve ezerszeresen túlbecsülték (24. oldal), ma mindez pedig már több nagyságrenddel olcsóbb. ↩
Unicode NFC, azaz “Normalization Form Canonical Composition”. ↩
Laki László, Kőrös Ádám, Ligeti-Nagy Noémi, Nyéki Bence, Vadász Noémi, Yang Zijian Győző, Váradi Tamás: OCR hibák javítása neurális technológiák segítségével, in: XVIII. Magyar Számítógépes Nyelvészeti Konferencia (MSZNY 2022), Szegedi Tudományegyetem, Szeged, 2022, 417–430. oldal. ↩
Csányi Gergely Márk, Nagy Dániel, Vági Renátó, Vadász János Pál, Orosz Tamás: Challenges and Open Problems of Legal Document Anonymization, Symmetry, 13(8), 2021, 1490. ↩
Csányi Gergely Márk, Lakatos Dorina, Üveges István, Vági Renátó, Megyeri Andrea, Fülöp Anna, Nagy Dániel, Vadász János Pál: Bírósági határozatok automatikus mondatszegmentálásának hatékonyságmérése, in: XX. Magyar Számítógépes Nyelvészeti Konferencia (MSZNY 2024), Szegedi Tudományegyetem, Szeged, 2024, 3–15. oldal. ↩

